本文来自微信公众号: APPSO ,作者:发现明日产品的,原文标题:《10 亿 Token 开源万只假鸟, AI 伪科普正在「污染」下一代的常识》
「有一回藤野先生将我叫到他的研究室里去,翻出我那讲义上的一个图来,是下臂的血管,指着,向我和蔼的说道:“你看,你将这条血管移了一点位置了。──自然,这样一移,的确比较的好看些,然而解剖图不是美术,实物是那么样的,我们没法改换它。现在我给你改好了,以后你要全照着黑板上那样的画。”」
这是鲁迅散文集《朝花夕拾》里的文章《藤野先生》,是每个上过初中的学生都会读到的一篇课文,在今天重新来看,多少有点荒谬——也就是藤野先生没有见过AI。
今天,不用去野外吹风淋雨,也不用懂半点鸟类解剖学,只要有一台电脑、开8个窗口跑AI脚本,不到一个星期,就能把全世界所有现生鸟类「一张不落」地全部画完,至于真不真实,根本不重要。
这是最近在开发者圈高调刷屏、却把国内外鸟类爱好者气到血压飙升的「花叔全球鸟类贴纸库」,光是看作者自己的项目复盘文章,字里行间都洋溢着一种「算力大力出奇迹」的亢奋。
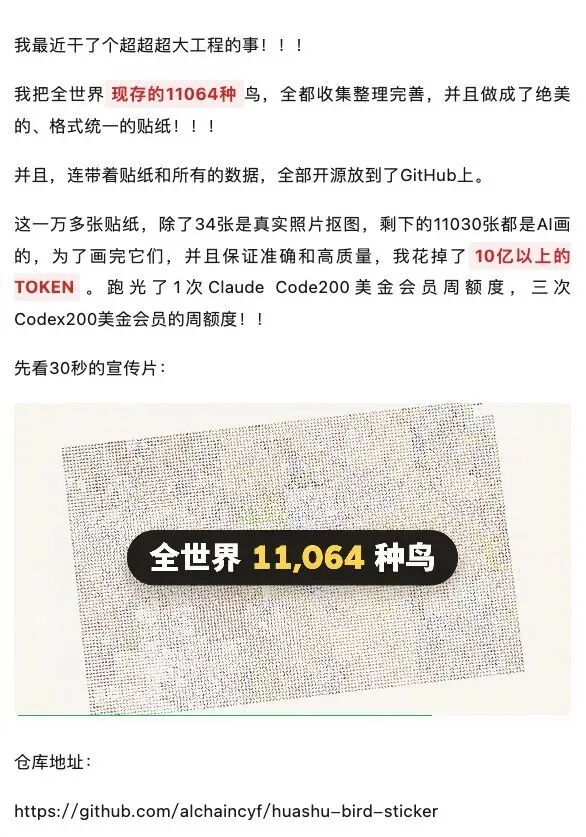
为了给自己的观鸟App做配套素材,这位完全不会写代码的独立开发者,靠着Vibe Coding烧掉了超过10亿的Token,跑光了数次200美元顶配会员的周额度,把全球11064种现生鸟类(后随名录更新调整为11011种及91个亚种)做成了白边贴纸,顺手搭起了一个支持15种语言检索的鸟类网站,并向全网宣布「正式开源」。
然后马上就翻车了。
扒图、瞎画,一条「造鸟流水线」
仔细看这套万鸟贴纸库的制作黑箱,足以让科学传播者和野外摄影师直掐人中。
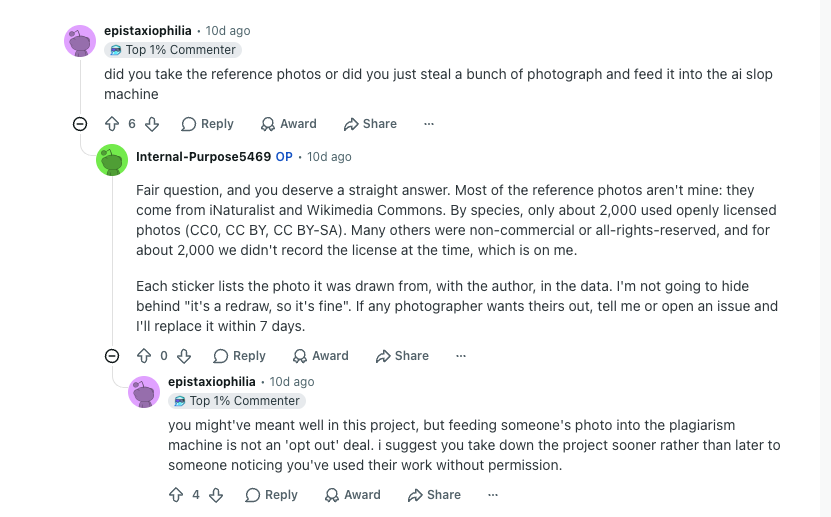
首先是近乎「明抢」的参考图抓取和盗图。AI凭空画鸟极易胡编乱造,作者又不是观鸟爱好者,没有自己的数据库,要怎么解决?写脚本去iNaturalist和维基共享资源里,把全世界摄影师辛苦蹲守拍下的真实照片批量扒下来,拼成3×3的「九宫格」喂给生图模型重绘。
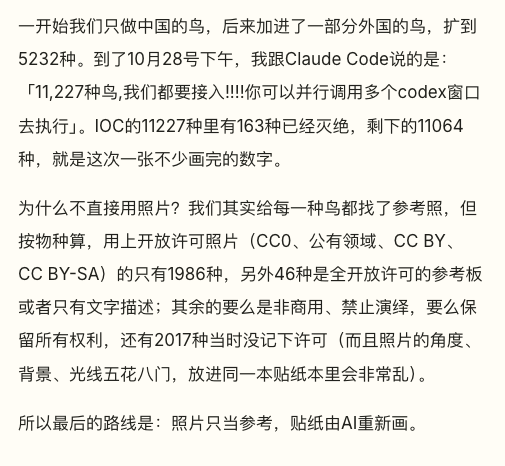
在这11064种鸟的参考照里,真正采用开放许可(CC0、CC BY、CC BY-SA)的只有1986种,剩下的要么明确标着「非商业使用」「禁止演绎」或「保留所有权利」,甚至还有2017种连许可协议都没记下来,就被一股脑塞进了AI里。
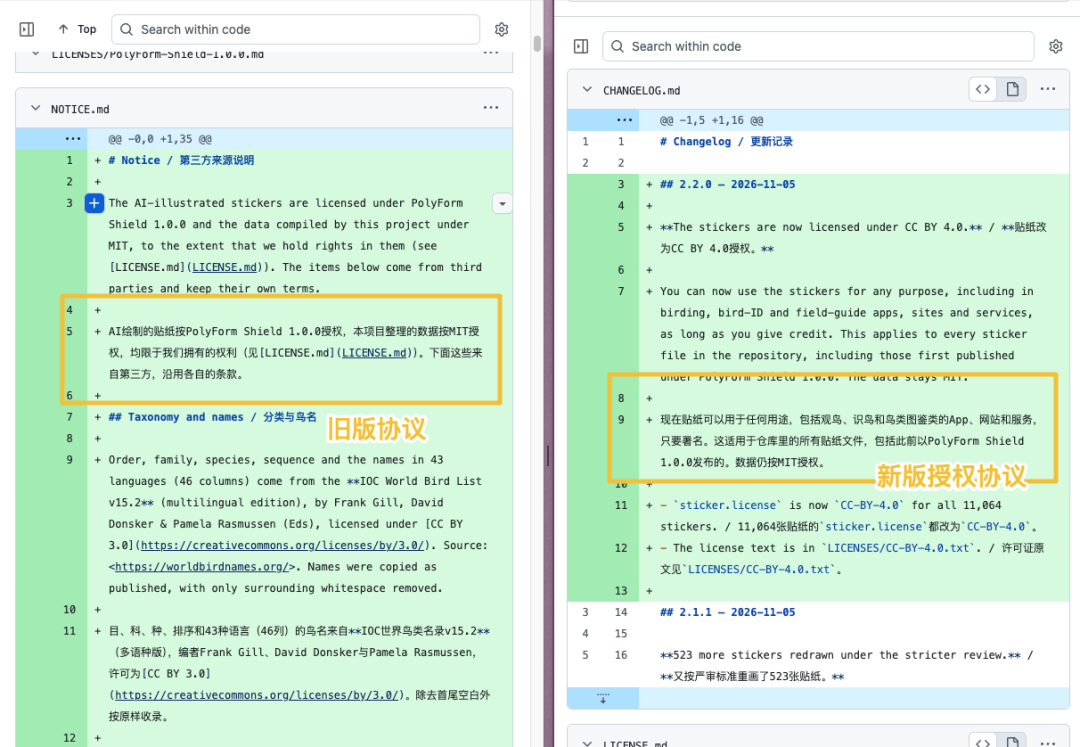
等洗成AI贴纸后,作者反手给贴纸打上自己的授权标签(最初甚至用了限制竞品使用的PolyForm Shield 1.0.0,后改为CC BY 4.0),然后留下一句:如果某张贴纸参照了你拍的照片而你不希望我们使用,发邮件提Issue,7天内撤下。
这种「先把摄影师的作品喂给AI、被苦主找上门再删」的逻辑,在海外社区Reddit的观鸟论坛上是直接被怼,「把别人的作品喂进抄袭机器,从来不是一件可以靠“事后申请退出”来洗白的事」
为了在几天内强行凑齐一万多种鸟,还有另外一个雷霆的做法:冷门鸟找不到好照片,就拿几张残缺照片拼凑;模型画完后,交给另一个AI审核员打分。在测试中作者自己都发现,生图模型频繁造出令人啼笑皆非的怪物——明明是红色或蓝绿色的虹膜,被画成了死气沉沉的全黑眼珠;脚趾融成一团肉块;连蜂鸟这种极短腿的鸟,都被强行安上了一双麻雀式的大长腿。
那要是重画两次还是画不对怎么办?不退回用照片,也不留空,选高分者留下。
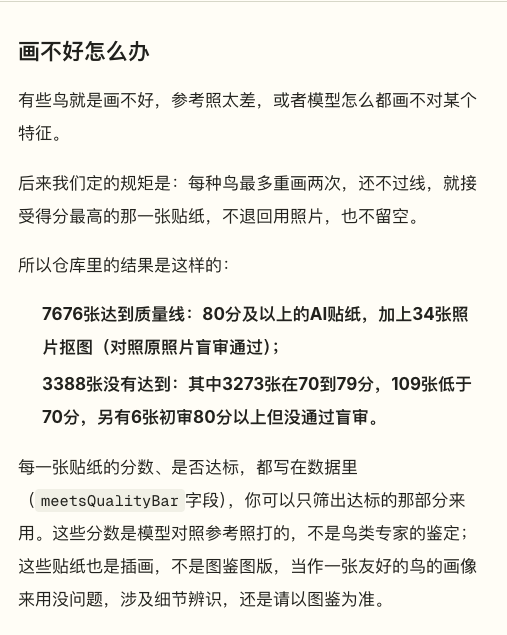
用纯工程学思维,搪塞科普问题,在初代开源的仓库里,连项目自己设定的AI及格线(80分)都没过的残次品,就高达3388张(其中109张甚至低于70分),却依然打包塞进了公开图库。虽然后来作者在11月用另一套AI标准把一万多张图重跑了一遍,宣布全部「过线」,但从头到尾,这套图库都没有经过哪怕一位鸟类学专家的系统审校。
「科普污染」究竟有毒在哪儿
在一大堆硬伤的情况下,依然热情推荐大家把这些贴纸拿去「做自然教育的课件、给孩子做鸟卡」,甚至提供了一行代码即可调用的CDN接口和绑定了eBird、GBIF科研编号的结构化数据;转头又在说明文档里给自己叠上一层厚厚的免责甲。
「这些是插画,不是图鉴图版……发现画错了,欢迎提Issue,鸟友的纠错是这个项目最需要的贡献」。
这是整个开源项目最大的争议点:有没有能力核查一万多张图片,是能力问题,但有没有想过在推出前做专业核查,是态度问题。作者从来没有正面承认过,制作一套鸟类知识产品,需要以鸟类学和观鸟领域的专业知识为前提,纠察是在发布之后的补充环节。
这种思路在代码开发里很普遍,编程-上线-收到issue后后修改-迭代,作为开发者,只要开发出了工具、生成了图片、开放了代码,自己的工作就已经完成,哪怕只是vibe coding,至于知识是否准确,可以交给使用者和专业社区来纠正——这样的思路放在自然科学领域,堪称灾难。
以有「空中猛禽」之称的游隼为例,如果只看贴纸图,外行人根本看不出问题,尤其是整个制图风格是写实画风,而不是动漫或者简笔画线条。
经过鸟友贴出的对比图仔细看,才能发现原本跗跖粗壮、爪趾强健有力的空中猛禽游隼,被扭曲成了更细小的爪型。作者回查后才承认,原来参考照是从树下仰拍的,游隼的脚被腹羽和树枝挡住了;当脚本自动抠图去掉树枝后,AI只能脑补出一副细爪,而负责审图的AI根本没检查腿脚粗细比例。
葵花鹦鹉最初激发作者立项,是他「最爱的鸟类」。
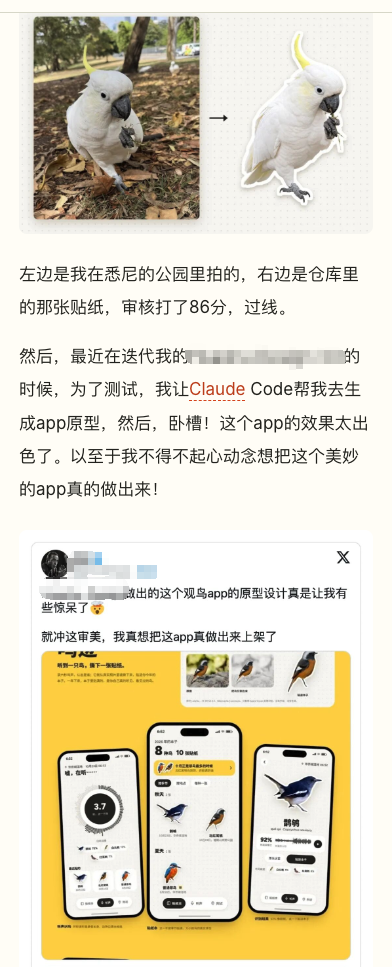
但画出来之后最基础的折叠翼羽区(覆羽与飞羽的层级关系)都是错的。
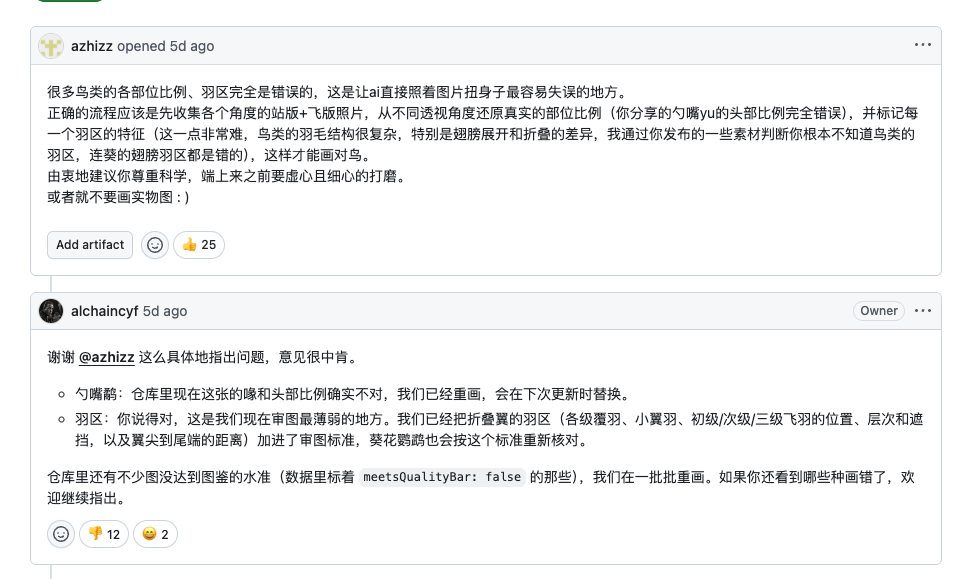
「是插画不是图鉴」这种说法,并不能免责,原因不是「鸟类图鉴不能用画的」,传统手绘图鉴本来就不等于摄影照片。但手绘取舍的底线,是每一笔都扎根于真实的物种解剖,并由懂行的人把关。优秀的博物画师会综合多只个体的长期观察,有意突出尾羽、喙形或换羽期的鉴别特征。
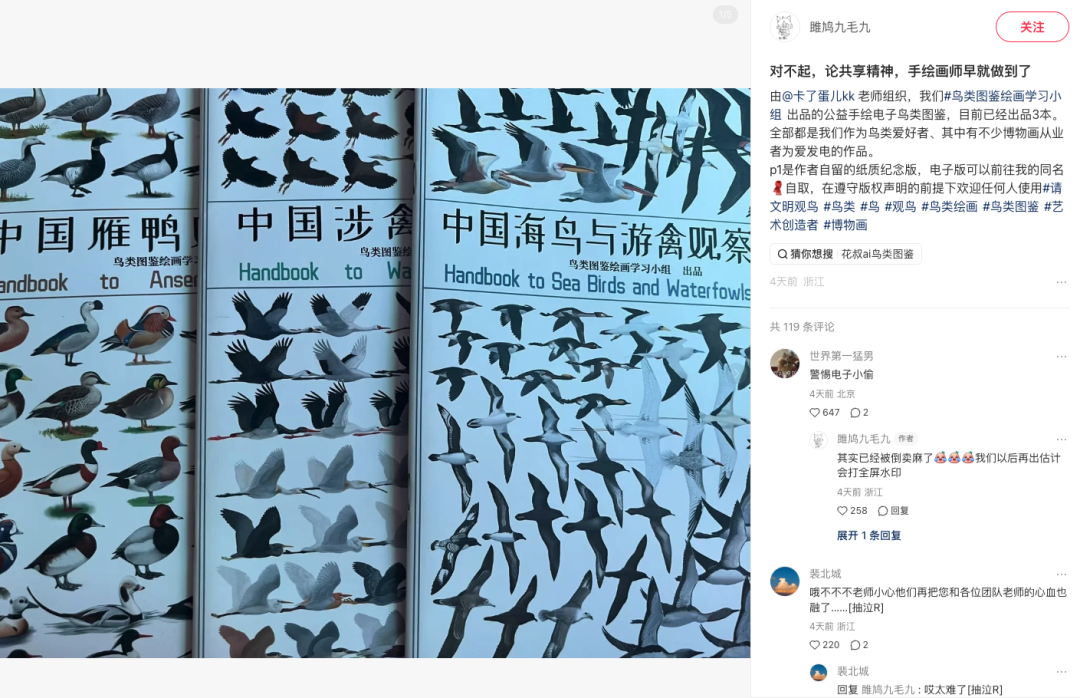
不止假鸟贴纸,AI伪科普正在多条战线「投毒」
如果仅仅是一个独立开发者的自嗨,事情或许还没那么可怕。可是像这样用AI篡改、捏造自然图像,进而污染科学记录与公众科普的离谱事件,早就不是一桩两件了。
今年发表在《自然·生态与进化》(Nature Ecology\&Evolution)上的一篇学术通信,就记录了一起足以敲响警钟的案例:一名观鸟者在巴西拍到了一只略显模糊的鸟,为了看得更清楚,他把照片交给Google的AI图像工具改善画质,随后将处理后的高清图上传到了全球最大的公民科学平台之一iNaturalist。
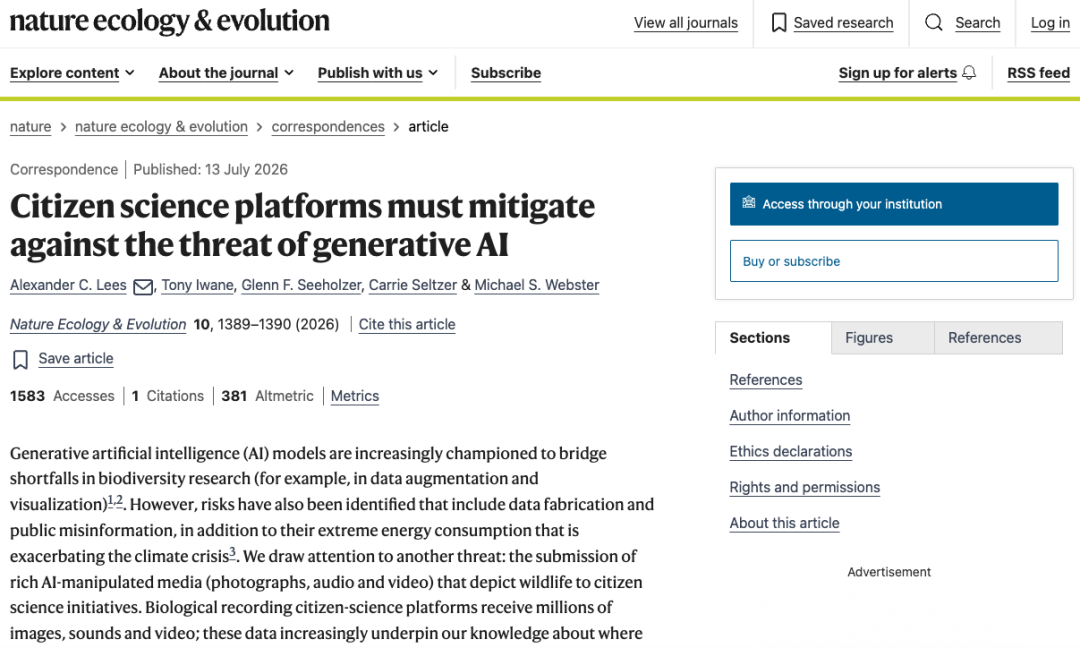
结果,这张照片一度被当成当地罕见的「红翅黑鹂」分布新记录;直到专家仔细比对原图才发现,那其实只是当地极其常见的另一种拟鹂,是AI在「修清楚」的过程中,凭空给这只鸟补出了红翅黑鹂的羽毛特征——只是换了一点色、调整了大小,就已经是另一只鸟。
这位观鸟者的主观意图,仅仅只是增强和高清,并没有其它意图。但恰恰是这种「无心之失」,比凭空画一只假鸟更容易混进人类知识的底层链条。公众上传的自然影像不仅供他人辨认,更直接作为全球物种分布研究的科学证据。
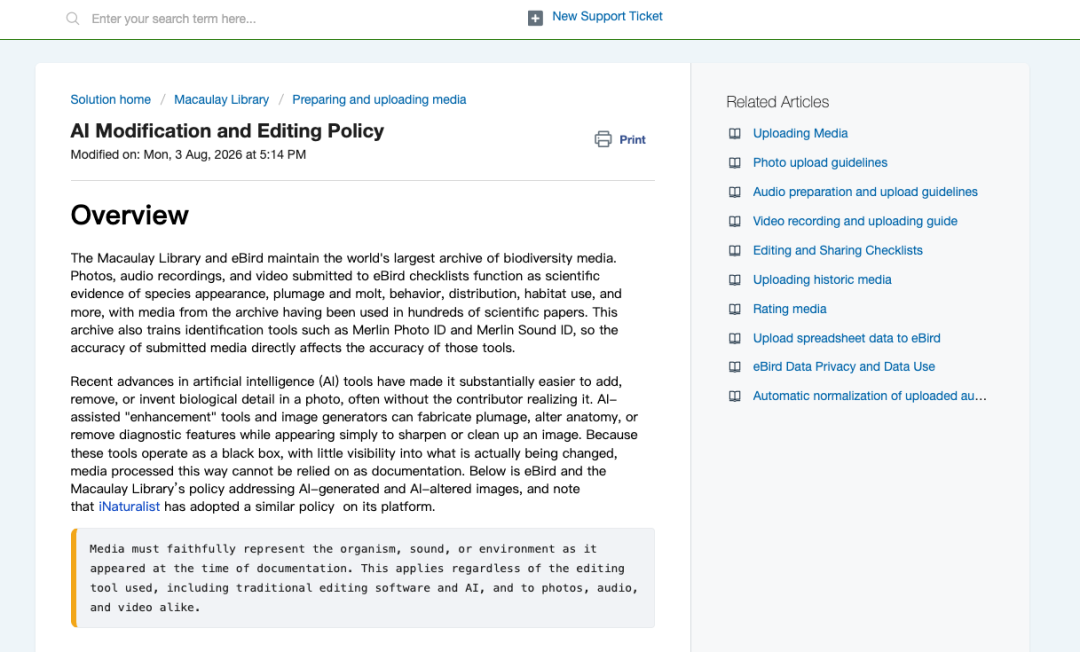
例如eBird的照片会进入康奈尔鸟类学实验室的麦考利图书馆(Macaulay Library),并反哺著名识鸟工具Merlin的图像与声音识别训练集。如果图中的鸟被AI悄悄改了羽色、脚趾或喙形,错误绝不会止步于一张失真的照片,它会形成一系列的多米诺骨牌反应,改变后续的科研人员和AI工具如何认识真实的自然。
而在公众科普出版领域,失守的速度同样惊人。
就在今年10月底,由中国农业出版社出版发行的《南海海洋生物科普丛书》遭到读者公开质疑,在介绍斑节对虾的分册封面与内页插图中,赫然出现了一只长着两个脑袋的诡异「双头虾」。
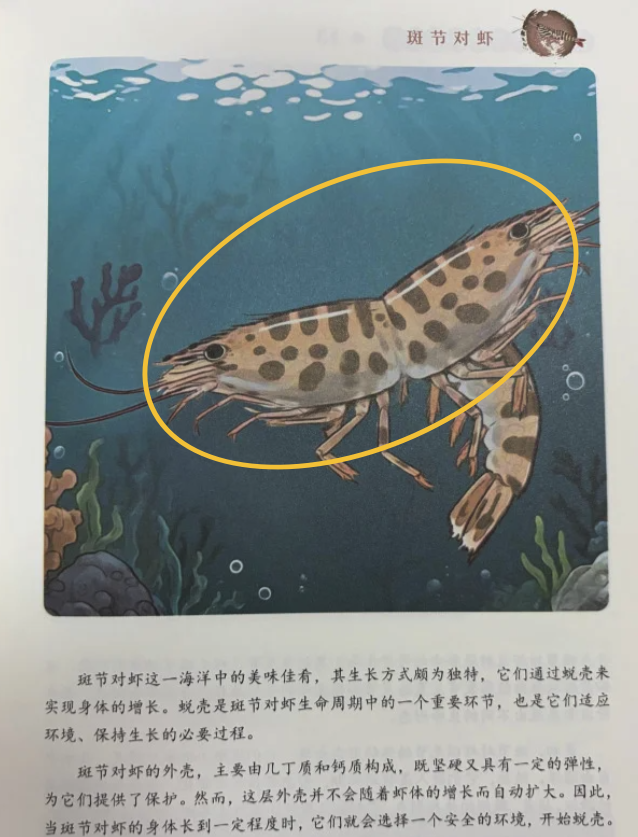
面对全网群嘲,人们翻开书本序言才赫然发现上面写着:「本套丛书里绝大多数图片由AI绘图工具生成」。最终,涉事出版社工作人员不得不回应称正在通知全网下架并召回图书,新华网公开批评。
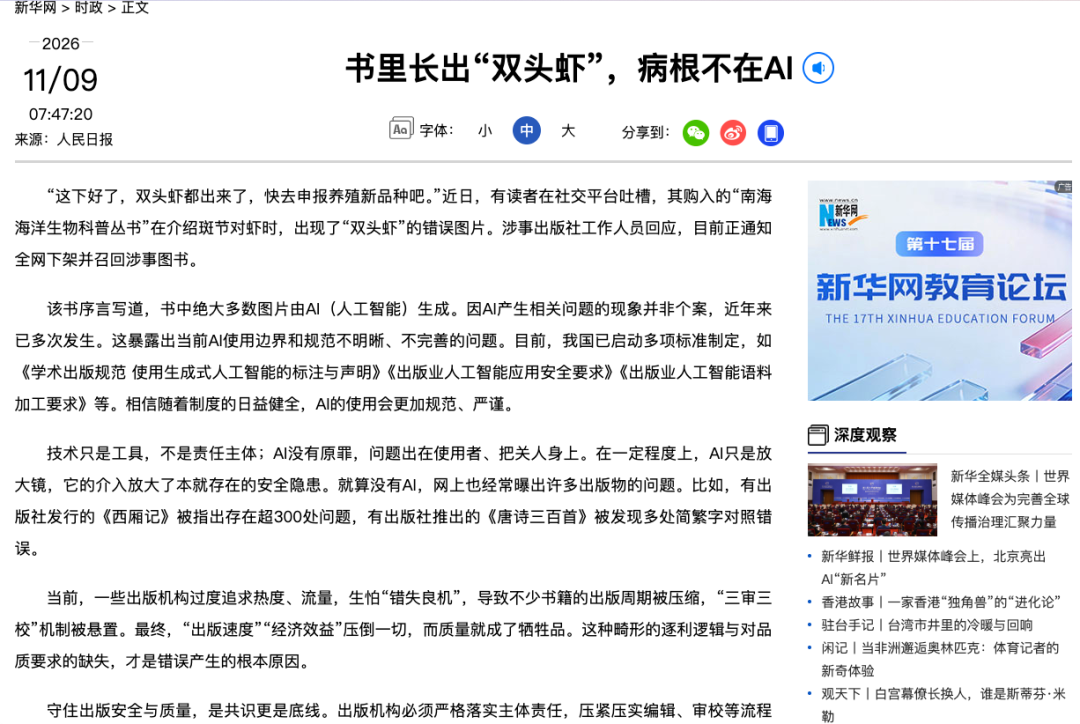
一只长着两个脑袋的「双头虾」因为过于惊悚,还能被读者一眼揪出来,但那些只画错了一根翅脉、多添了一枚脚趾、或是篡改了尾羽斑纹的AI科普插图,一旦经过正规排版印刷,带着「科普图书」的权威光环摆上书店货架,普通读者和孩子该怎么分辨?
对严肃的科学记录而言,有时最危险的图像甚至连「AI插画」的外观都没有,而是披着「真实照片」的外衣潜入数据库。
把大自然的面貌,还给耐心的观察
面对汹涌而来的生成式图像,专业的自然观察数据库已经在筑起高墙,给出了远比「请谨慎使用AI」更硬核的准入红线。
例如,eBird和麦考利图书馆明确禁止上传任何AI生成的图像、声音和视频,同时严禁使用生成式工具增补或重建照片原有的羽毛、眼睛等细节;只有裁切、常规曝光与色彩调整以及不捏造细节的轻微降噪才被允许。一旦违规,素材会被打上「过度编辑」或「人工生成」标签,屡犯的账号甚至会被限制权限。它的判断核心不是你用了哪款修图软件,而是上传物能否作为当时当地那个生物个体的真实证物。
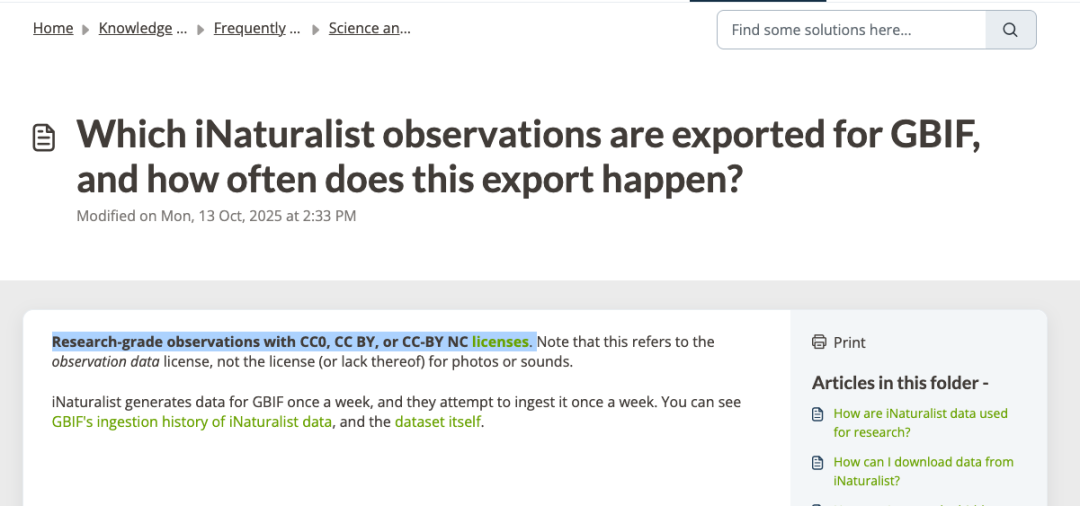
iNaturalist也上线了针对性的拦截机制,一旦社区发现主要由AI生成的照片或录音,即可打上「人工生成内容」标记,原图会被替换为警示图,该条观察记录也会被直接降为「普通级(Casual)」,永久踢出「研究级(Research Grade)」序列。对于真实照片但因AI修图失真的案例,则走专门的数据质量评估通道。
由于iNaturalist向全球生物多样性信息平台(GBIF)共享的主要是符合许可的研究级记录,这一降级机制相当于在科研数据源头层面装上刹车片。
这些平台规则至少捍卫了一条底线:把「好看」和「能作证」彻底分开。一张糊得像马赛克的原片,依然可以是一条诚实的科学记录;而一张由AI补齐了纤毫毕现的羽毛与眼神光的高清大图,在科学证据面前,没有价值。
然而,仅有专业数据库的防守还远远不够,甄别假图依然极度依赖人类的专业眼力,来源溯源证明代替不了内容准确性审查,公共互联网的「劣币驱逐良币」,都让「投毒」行动难以被遏制。
在公民科学数据库里,一张图片首先是一份现场证据;在博物图鉴与科普读物里,一幅插图是一份经过专业核对的知识契约;而在社交娱乐平台上,它成了一个吸引流量的帖子,一件「我很会用AI」的时尚单品。
「算力可以代替专业」背后是十足十的傲慢。在没有领域专家把关、没有解决原始摄影作品授权的前提下,人不能、至少不应该把严谨的自然科学当成炫耀Token消耗量和AI技能大赛现场,更不应该把严肃的科学审校义务转嫁给社区去「免费排雷」。
大自然从来不是一段可以靠提示词批量生成的脚本,在这个生成一万张图比去公园认清一只鸟容易太多的时代,我们需要比以往任何时候都更加审慎。
