

 读报 ›
理想芯片子公司正推进首轮外部融资,投前估值约150亿元,计划融资数十亿元。工商信息显示,一家名为Mach Intelligent Cores Limited(下称 “Mach香港”)的公司于7月14日在香港成立。8月4日,Mach香港全资持有的上海马赫智芯智能科技有限公司成立,理想CTO谢炎担任法定代表人。数日后,上海马赫智芯又全资设立上海马赫心科技有限公司,法定代表人为理想联席公司秘书王扬。(晚点Auto)
理想汽车的马东辉在媒体沟通会上表示,马赫芯片、碳化硅模组等自研的标准化产品可对外输出,这类芯片体积小、通用性强,其他厂商可完成适配。但根据自身整车需求、车型特点定制开发且产能匹配自身整车产能的自研 PACK 包无法对外输出。
2026年,继存储芯片之后,华尔街看到了“光”。
标普500指数年内涨幅TOP10的成分股中,光通信公司占了三席;3月初,英伟达向Lumentum、Coherent两家光学公司各投资20亿美元,并附加了数十...
2026年,继存储芯片之后,华尔街看到了“光”。
标普500指数年内涨幅TOP10的成分股中,光通信公司占了三席;3月初,英伟达向Lumentum、Coherent两家光学公司各投资20亿美元,并附加了数十亿美元的长期采购承诺。
资本热度背后,是AI算力架构的结构性变化。当单集群算力迈向十万卡量级,GPU之间需要高速交换海量数据,传统电交换网络在功耗、带宽与扩展性上逼近物理极限。
解法之一是“以光代电”,让信号不再经历“光-电-光”的转换,而是始终以光路形态完成路径切换。这就是光电路交换机(Optical Circuit Switch,简称OCS)的由来。
36氪获悉,OCS整机商武汉芯信光科技有限责任公司(以下简称“芯信光”)近日完成数千万元Pre-A轮融资,由毅达资本领投,优山资本、建华投资跟投,日新资本担任财务顾问。本轮资金将主要用于OCS产品迭代、量产体系搭建以及团队规模扩充。
芯信光2025年9月成立于武汉光谷,据创始人兼CEO魏俊介绍,其核心团队来自业内一线大厂,有过数千台OCS整机量产经验,交付过多个国内外大客户。
出于对整机下线良率及产品性价比的考量,芯信光选择了经谷歌量产验证的MEMS微镜路线。这一方案在端口规模、插损、可靠性等维度的综合表现,更符合数据中心大规模部署的需求。
技术路线的工程落地经验,也是这支团队的积累所在。核心成员平均从业超过15年,具有MEMS-OCS从设计、封装到校准、终测的全链条经验。面对算力网络的升级浪潮,他们正在将这套量产Know-how,复用到AI数据中心时代。
想理解芯信光做的事,就要先看懂传统电交换的瓶颈。
在传统数据中心网络中,服务器之间传输的是光信号,而交换机内部处理的却是电信号。这种“光-电-光”的转换可以比作地铁换乘——数据被迫要在中途下车、换乘、再上车,而每一次换乘都在消耗能量和时间。
OCS更像是一条直达的立交桥。它的工作原理可以这样理解:整台交换机是一个“黑盒子”,两端是阵列排布的入光口和出光口。光从一端射入,打在盒子内部的MEMS微镜阵列上,微镜通过静电力改变偏转角度,精准地把光束反射到对应的输出端口。
这个过程只改变光的传播路径,不改变光信号本身,自然也省下了转换环节带来的延迟和功耗。
但这并不意味着光交换要取代电交换。对于二者的关系,魏俊给出的判断是,整个AI集群网络正在走向电光混合架构,现阶段OCS承担的更多是高带宽、通信模式相对稳定的直连路径,适用于AI训练中规律性强的大流量调度;电交换则继续负责突发性、碎片化的分组转发,二者互补共存。想要实现端到端的全光交换,整个产业链还有很长的路要走。
那么机会窗口为何在此时打开?答案指向供需的矛盾。
谷歌已披露2026年需要约1.5万台300端口OCS交换机,其中约3000台计划外购;英伟达则将OCS写进了自己的AI工厂网络规划,计划在新一代架构中引入。Cignal AI预测,全球OCS市场将在2030年超过80亿美元,对应2026年至2030年复合增速超30%。
但供给端明显跟不上。Lumentum管理层在财报电话会上直言即便满产运转,供货量仍落后于需求,其中OCS积压订单已超4亿美元;Coherent也透露其积压订单已创历史新高。
随着谷歌集群架构升级和新客户的导入加速,海外厂商难以承接所有需求,这段供需之间的时间差,给新入场者留出了窗口期。
作为一个系统级产品,OCS的设计与生产涉及光路稳定性、器件一致性、装配精度、测试流程、长期可靠性等一���列工程问题。这些问题难以通过原理验证来解决,需要在实际的量产过程中不断优化调整,才能逐步形成可复用的解决方案。
辗转各大厂商,魏俊在光通信行业已经走过20年。他身边的核心团队成员覆盖光学、机械、电子、软件、算法等领域,针对OCS量产具有10年以上经验。
这支团队在三个环节上形成了自己的积累。
第一是自制核心器件。OCS整机里最难做的器件之一是FAU(光纤阵列单元),几百根光纤要与精密透镜阵列耦合对准,公差以亚微米计——相当于在一根头发丝的百分之一量级上做对齐。芯信光把2D-FAU做到了400通道以上,并自研了对应的工艺路线。同样的自制能力也延伸到MEMS驱动、芯片封装等环节上。
第二是校准算法。出厂校准是高端口OCS量产节奏的关键瓶颈。OCS内部的光路组合以十万条计,每台整机出厂前都要逐条校准。对于没有经验的厂家而言,校准可能需要数月时间,而芯信光通过自动化算法把这一时间压缩到了3天,大幅缩短了产品下线周期。
第三是成品率。一台高端口OCS整机涉及上千个零部件、70—80道工序,让每一台设备都达到同样的性能指标,是量产阶段最大的挑战。据介绍,目前芯信光在产线磨合期良率已达90%,时延、插损、功耗等核心指标也达到了主流水平。
上面这些经验回答的是“怎么做出来”,但面临新的市场环境,产品自身应该怎么定义,是另一道题。
AI数据中心对OCS端口密度、功耗、成本的约束,与电信时代已经完全不同。团队的做法是从批量生产、功能增减和成本控制出发,倒推产品设计。
“我们做的并不是把十年前的S320搬回来,而是在现在的市场需求下重整产品架构,进行技术迭代。”魏俊说,“比如光路的仿真、算法的优化,都在设计阶段就纳入了考量。”
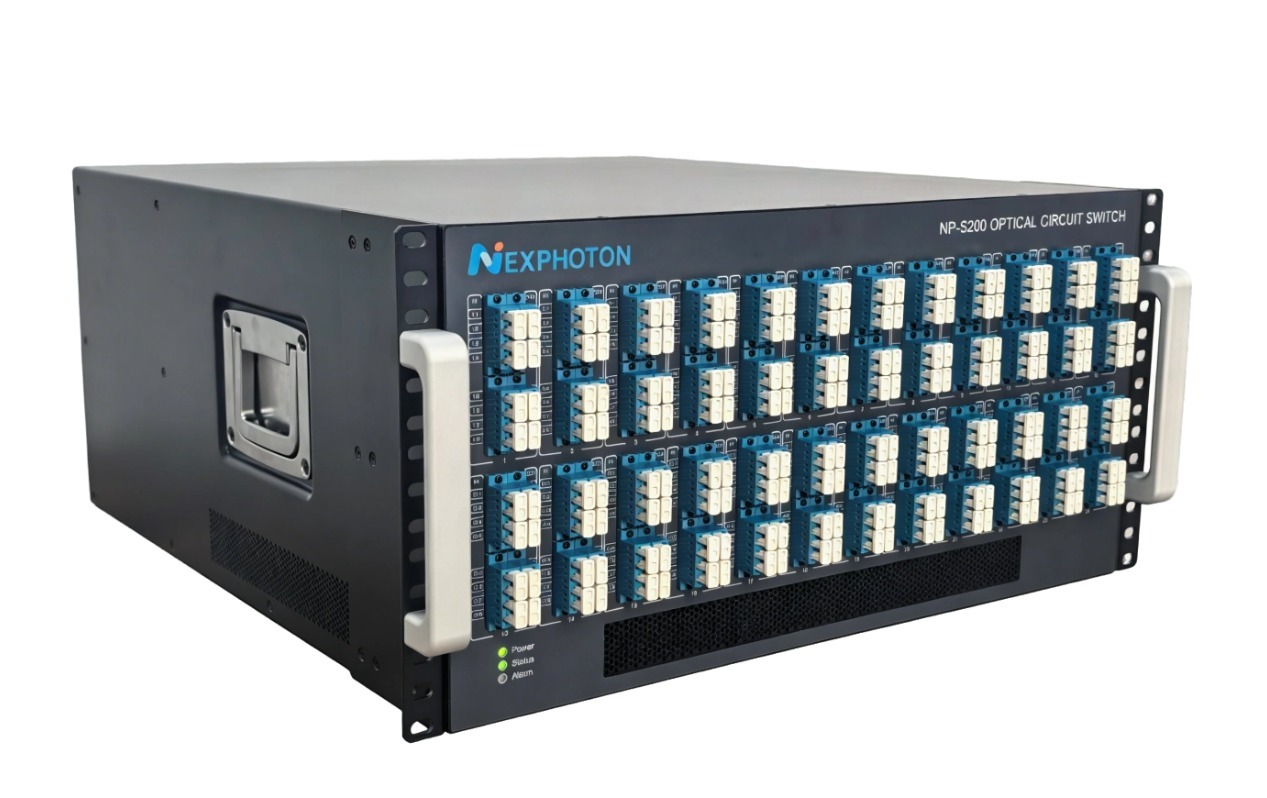
在前不久结束的光博会上,芯信光携NP-S200 Series OCS首次公开亮相。据介绍,NP-S200覆盖64/128/192端口,采用可插拔式设计,便于冗余替换。如遇端口故障,不必整机返修或者更换软件,迭代功能也可按需在整机上进行模块化嵌入。
NP-S200 Series OCS产品示意图
在产品规划上,芯信光将推出H400/S400系列,覆盖256/320/384高端口产品,其中320端口(谷歌新一代集群规格)为重点方向,预计在2027年推出批量化产品。
技术能力最终还是要接受市场检验。芯信光没有全部押在整机上,而是同时铺开三条现金流业务:有源/无源光器件、封测服务以及子系统代工。
“在自有品牌整机放量之前,先把产线和制造能力转化成真金白银的收入。”这套打法源于魏俊对节奏的判断。
在他看来,技术领先不等于能活到最后。行业中不乏这样的案例:场景落地不及预期,现金流率先承压、团队流失;等到市场爆发时,企业却丧失了产品迭代能力,只能眼睁睁错失窗口。所以既要紧跟节奏,也不能在需求真正到来之前把弹药打光。
在商业化进展方面,芯信光目前正在通过海外代理渠道接触客户,意向订单主要来自海外云厂商和测试机构,明年3月将亮相北美OFC展,直面海外客户。
产能端,2000平米新厂房启用在即,规划千台级年产能,预计今年底到明年初具备批量交付能力。东南亚生产中心也在同步规划中。
面对竞争格局,魏俊的判断是乐观的:海外巨头在资金和产能上占优,但就OCS的量产交付环节来说,国内厂商的差距并不悬殊。对有能力、有经验的初创企业而言,反而留出了一定的市场机会。
在更长的周期里,他给公司的定位不止于OCS整机:“我们希望成为AI数据中心全光交换的解决方案提供商。不光是OCS,还包括DCI、环行器、隔离器、MPO等光器件。凡是数据中心用到光的地方,都提供全方位的支持。”
从算力芯片到光器件,再到今天的网络架构,回顾过去两年由AI基建传导出的产业机会,多数都呈现出了一个特征:需求先到,产能后至。
谷歌十年研发部署、英伟达40亿美元先后背书,时至今日,OCS的技术方向已经无需论证。当下真正的悬念在交付——面对以万台计涌入的需求,如何从展示样机走向稳定量产,弥合供需之间的缺口。
对于新入场玩家来说,一场工程化的考验才刚刚开始。
“都得抢着早发布、早开卖,”一位前手机厂商战略研究员说,“之前为了避开iPhone,安卓新品发布普遍安排在10月。”
手机厂商之间“神仙打架”,既有出于“黄金周”、“双11”假期的考虑,也有国产高端旗舰与iPh...

“都得抢着早发布、早开卖,”一位前手机厂商战略研究员说,“之前为了避开iPhone,安卓新品发布普遍安排在10月。”
手机厂商之间“神仙打架”,既有出于“黄金周”、“双11”假期的考虑,也有国产高端旗舰与iPhone正面对决的因素,也还有小米17 Pro的成功方法论。
“去年只有苹果和小米在9月发布,小米正好出个背屏,天天拿来宣传,整整早卖了一个月,今年大家都吸取了‘教训’。”前述研究员说。
不过,无论是哪一点,都足以说明智能手机市场竞争的激烈程度。
整个9月份,华为和小米同日发布新品,前者拿出了新一代三折叠Mate XT2,小米则推出中折叠旗舰小米18 Fold。随后苹果发布Phone 18 Pro系列以及首款折叠屏iPhone Duo。
如果将OPPO、vivo等计算在内,整个9月的新品发布接近10场。
价格上,高端旗舰价格普遍超过10000元,部分甚至冲到20000元。与此同时,更底层的芯片也升级到了最新一代:包括华为的麒麟9050、小米玄戒O3、苹果A20 Pro、联发科天玑9600 Pro、高通第六代骁龙8至尊版系列。
可以说,手机厂商们带着内存涨价的压力,参与到了2nm芯片争夺战当中,这中间还有一个非常明显的变化:芯片厂商正在集体“All in AI”。
关于2nm芯片,2025年联发科是最早进行传播的。联发科CEO蔡力行先是在2025年Computex预告,然后9月份对外官宣全球首个2nm SoC启动流片。
流片领先并不代表着量产领先。
真正的2nm手机芯片战,直到今年9月随着苹果A20 Pro的亮相才正式开启。“采用最新的2nm工艺技术打造,A20 Pro为移动计算树立了全新的标杆。”苹果在官方新闻稿中强调。
从量产上市的时间上,苹果是当仁不让的2nm首发,而从客户体量来说,苹果也必然会拿到2nm的首发权益。
“台积电今年2nm晶圆产能差不多100K,苹果占了其中70K左右。”长期跟踪台积电产能的蓉和半导体咨询CEO吴梓豪说,“联发科出货量不大,(天玑9600 Pro)这颗芯片几千片晶圆就够了,高通大概10K左右,再加上AMD差不多20K,总共在100K左右。”
海通国际资深分析师Jeff Pu此前预测,苹果今年Q3、Q4要为包括iPhone Duo在内的新品备货7800万台,不考虑装配报废的情况,单月对A20 Pro的理论需求是1300万颗。
知名评测机构极客湾测算的数据显示,苹果A20 Pro的die size为98.8mm²。假设台积电2nm的良率为85%,以此推算,A20 Pro这颗手机芯片对产能的需求预计在25K左右,而剩下45K的需求,则会被分配给同样是2nm的M6芯片。
从客户的重要性角度来看,受AI需求的影响,苹果已经从台积电第一大客户的位置上滑落,遭遇英伟达反超,但GPU并不追求最尖端的工艺,现阶段苹果依旧是2nm的核心客户,这在过去多年都是如此。而苹果之所以能够拿到这样的权益,既有张忠谋时代与苹果建立起来的深度合作关系,也有iPhone在全球市场销量作为需求支撑。
联发科虽然高调官宣流片,但手机SoC对2nm的需求量要小得多。按照5K片晶圆的需求量、134.02mm²的die size以及85%的良率来推算,单月天玑9600 Pro的出货量大概在200万颗。
值得注意的是,联发科也在联合谷歌设计推理专用的2nm TPU,预计2027年底出货,这个后续进入量产环节,有可能大幅拉升联发科对台积电2nm的需求。
吴梓豪说:“虽然高通、联发科、苹果同台发布2nm芯片,但联发科的高端相对较少。尽管它现在是全球最大的手机芯片出货商,对应的是颗数最多,也都是中低端为主。”
根据Counterpoint Research的跟踪数据,到2026年第二季度,联发科在全球智能手机芯片市场份额为31%,环比一季度下滑2%。作为对比,高通和苹果分别为23%和19%。
另一个值得关注的话题就是,2nm虽然是今年主流工艺制程,但它和内存一样,价格也涨了。也因为这个原因,高通在二季度的业绩会上就预告,从9月1日开始涨价。
最终,晶圆代工涨价,也会像内存涨价一样,传导至终端手机上。消费者最直观的感受就是:手机价格又涨了。
涨价、扎堆发布也还折射出一个非常严肃的现实:存量竞争。
“整体大盘不好。”前金立手机副总裁俞雷说,“销售额其实没跌,跌的是台数,这几年都是如此。”
在俞雷看来,这种涨价一方面与供应链价格上涨有关,另一方面也与供应链国产替代、技术进步有关,一个直观的变化就是,屏幕,CIS,存储,射频,电源管理,这些都在逐步实现国产替代,进而让国产手机进化加速,最终将“日系”“韩系”手机打得遍体鳞伤,
国产进化的另一个点,也就是我们接下来要说的手机芯片自研。
以高通、联发科为代表的2nm芯片是一种解决方案,以苹果、华为和小米为代表的自研是另一种解决方案。
苹果自研芯片之路,充分证明了这条路径的价值,华为、小米也成为自研这条路上的践行者。不过,由于代工受限,相比苹果,华为和小米的自研之路更显得困难重重,但某种程度上又显得难能可贵。
9月7日,华为正式发布Mate XT2三折叠,搭载基于韬定律和逻辑折叠的麒麟9050 Pro芯片。这款芯片采用了W2W(Wafer to Wafer,晶圆对晶圆)技术,将传统的单层平面逻辑单元改为双层垂直堆叠,俗称在芯片里加装电梯。
逻辑折叠,是华为自研芯片在工艺制程受阻的情况下,一种全新的解题思路,是“韬定律”落地探索的重要成果。巧合的是,小米也采用了相同的W2W方案——推出了6nm工艺的玄戒O100芯片。
华为和小米的共性在于:先进封装为芯片设计厂商打开了压榨性能的大门。
不过,两家的差别也很明显:华为的W2W聚焦的是逻辑单元的堆叠,而小米的W2W是逻辑单元和存储单元堆叠。前者主要解决的是物理制程微缩瓶颈,后者想要改善的是内存墙造成的数据搬运效率瓶颈。
苹果、高通和联发科这些主流手机SoC今年都上了2nm,小米目前还停留在3nm,这里面其实有多重因素,我们过去讨论过很多,其中一个关键因素是GAA架构的限制。
当前的2nm制程,三星和台积电都切换到了GAA架构,带这一架构对应的设计软件,晶圆代工都受到严格限制。
“小米最多就能用3nm。” 前述前战略研究员说。
实际上,从规模的角度来说,现阶段的玄戒芯片,即便上2nm也未必是一件划算的生意,根源就在于出货量的规模化。
以苹果为例,单iPhone这个产品线,每年对自研芯片的需求量就在上亿颗的水平。目前,玄戒O1的出货量也刚过100万颗。我们去年也做过类似测算,真正能够产生规模化效益,可能需要出货量冲到1000万颗。从这个角度来说,国产自研芯片才刚刚开始。
但其实小米在这个3nm的玄戒O3上探索的思路,远比粗暴导入2nm更有价值。
根据小米披露的数据,玄戒团队对晶体管底层最小逻辑单元Standard Cell进行了重构,从O1的480个提升至当前O3的2400个。同时,玄戒O3采用了称之为Channelless的沟道消除技术,取消了过去SoC为了布置BUF单元来加强供电而预留的沟道,同时将BUF单元移动至其他模块,实现5%的晶体管密度提升。
如果让我来说它的价值,过去摩尔定律靠晶圆厂工艺制程迭代,实现单位面积晶体管数量18个月/24个月翻一倍。现在工艺制程进化速度放缓,很多人说“摩尔定律”已死,“摩尔定律”失效,但华为和小米,在制程受限的背景下,用另外一种方式,让“摩尔定律”焕发青春。
中国的芯片设计团队非常了不起,这也要承认。
不管是苹果的2nm,还是玄戒的3nm,今年有一个非常明显的共识——AI已经融入到各个核心的IP当中,CPU、GPU、ISP等不同核心都参与到AI推理任务的分摊中来。SoC正在从 “一颗单独NPU负责全部AI” 走向全子系统异构AI算力网络。
从这个角度说,All in AI,一点也不为过。
在这种算力网络下,大模型重负载依然优先跑NPU,短延迟轻AI任务直接跑CPU‑AI或者 GPU‑AI,分担碎片化、低延迟的小 AI 任务,减少片上的数据搬运开销。
此前,玄戒O3沟通会上,玄戒团队披露的数据显示:CPU包含了两个新的矩阵计算引擎单元,采用SME2指令集,提供3.5TOPS的算力,处理轻量级的AI工作负载。GPU子系统中采用了8核心NX神经加速单元,总算力36TOPS,可实现在GPU内部对图像渲染的AI超分和插帧的能力。
“大家都在做布局尝试,当前手机上的场景/价值上还不足,”一位资深芯片设计专家告诉腾讯科技。
“从技术演进趋势上说,GPU内嵌AI是明确的,看NV就知道,游戏场景上需要实时性强的场景也合理。CPU内嵌AI是做些小处理,可能大家还是看苹果干了以及ARM想推这个能力。这些都是确定的方向,具体方案上还可以不同。”
根据此前披露的信息,苹果采用的路线是CPU (AMX 硬单元)+GPU (内置神经网络加速器)+ 独立 NPU,三级异构AI算力。联发科的底层IP和玄戒O3同源,全计算子系统都增加专用 AI 硬件单元,是今年手机SoC里面走得最彻底的全模块AI化。
前述战略研究员也认同向苹果“抄作业”的思路。
“苹果CPU核心中的AMX主要做向量计算和矩阵加速,跑简单算法以及一些RNN模型,但不能并行计算,高通和ARM在去年就支持了QMX/SME,基本上就是照着苹果这个功能来做的。”
在他看来,这种设计理念核心是为了优化计算“成本”。“NPU计算需要计算核心传输调度任务,这里面有不少的成本。所以,就一些简单的计算能在本地(核心内部)进行了。”
将AI任务“就近计算”,一方面提高了效率,另一方面缩减了开销,将会带来整机能效比的提升,也有机会让手机厂商基于不同的IP的AI特性,探索个性化的能力。“OPPO做了一些主动智能的投入,可能会做出差异化来。”前述战略研究员说。
趋势和方向是确定的,探索则还处于早期,路线也没有统一。
“当前做得都还不太好,但以后AI融合可能会越来越多,(具体方案上)是在GPU内部内嵌AI,还是GPU+GPU外的NPU做紧密协同,都可以的。”前述芯片设计专家说。
也就是说,All in AI声量很大,行业也有共识,但真正让消费者为这些创新额外买单的,是可靠、稳定、高频使用的场景和能力。
本文来源:腾讯科技