AI推理时代,算力狂奔,但内存却掉队。
过去二十年GPU单精度算力提升了四个数量级以上,AI产业的注意力长期被芯片与网络占据,“算力焦虑”几乎成了行业的核心叙事。但随着大模型从实验室训练走向规模化产业落地,一个更隐蔽的瓶颈正在浮现:显存带宽与容量的线性增长,早已追不上算力狂奔的脚步。
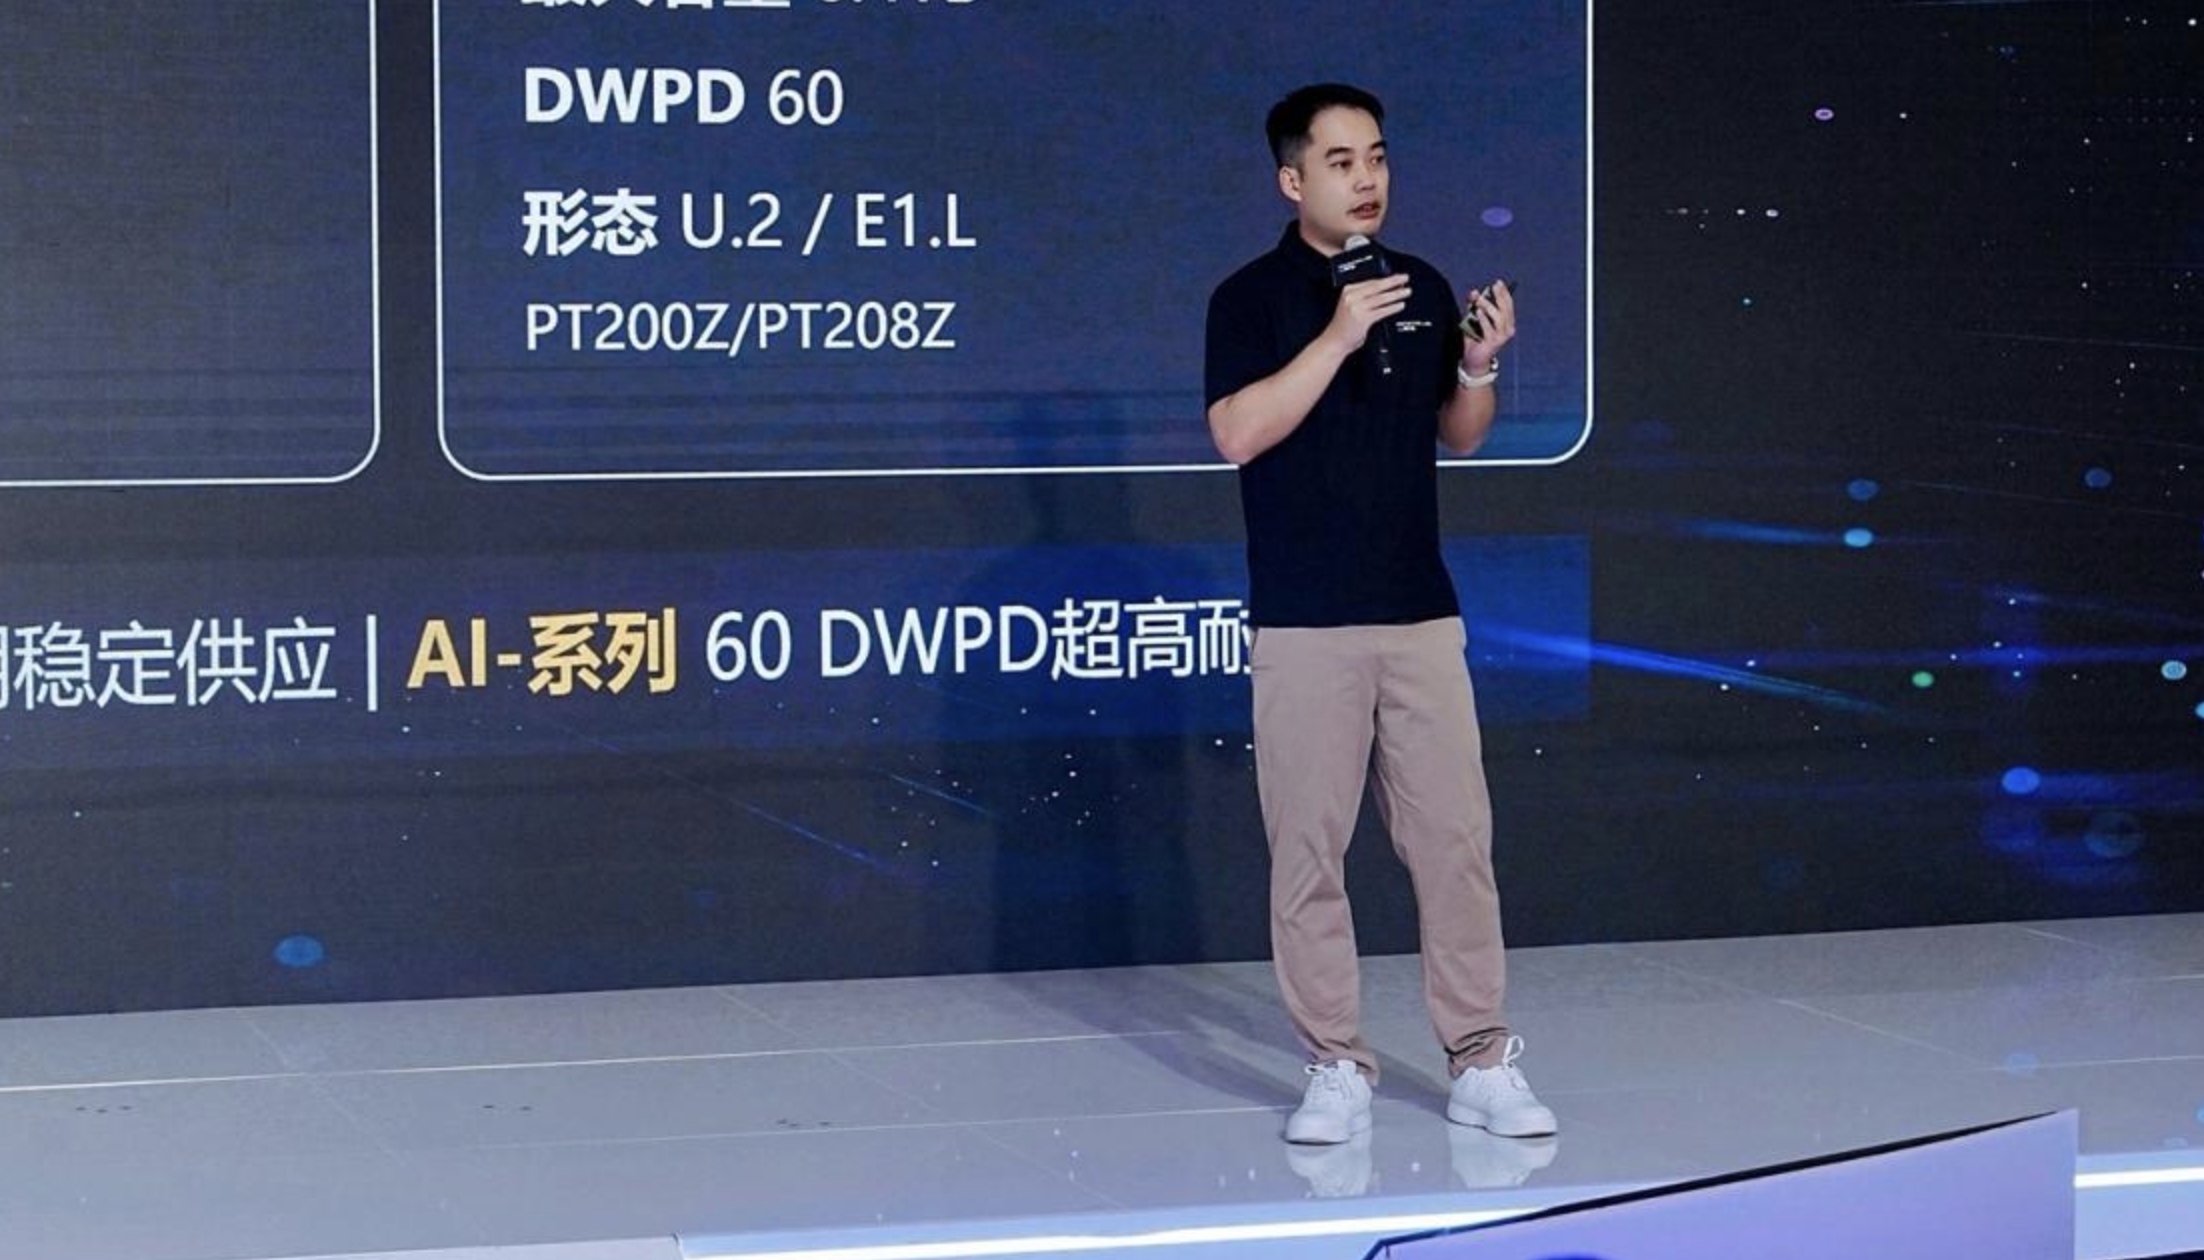
AI算力越堆越多,GPU却在等数据。“内存墙”之下,存储正从幕后的数据仓库走向台前,成为决定AI体验上限的关键变量。芯展速副总裁李蓁指出,"下一个十年,算力的差距会缩小,存力的差距才会决定谁跑在前面。"
内存掉队
过去谈及AI基础设施,算力芯片与高速网络是绝对的主角。行业的普遍认知是,只要算力堆得足够多,AI的能力就有保障。但当大模型参数跨过千亿,上下文窗口扩展到百万Token以及Agent应用批量兴起,在新需求下,旧供给已经跟不上,内存被卡了脖子。

“AI是基于数据实现的智能化应用,数据的规模、处理速度与流动效率,直接决定了AI智能体的智能化程度。”李蓁打了一个比方:就像一个人掌握的一手数据越多、知识越渊博,应对复杂场景的判断就越精准。AI要真正融入千行百业,就需要持续喂养海量数据,而数据的承载、流转与调度,都离不开存储。
这也解释了存储为何在近两年迅速升温,从来没有任何一种应用,像AI这样对数据有着极致的规模与效率要求。要知道,早期AI存储只需要满足模型训练的高吞吐、大容量需求,而如今AI数据管道覆盖采集、清洗、训练、检索、推理、反馈全链路。
数据不再是静态存放的资产,而是在全流程中持续流动的生产要素。如果数据流动受阻,再强的算力也只能陷入等数据的空转。换句话说,以前的问题是算得慢,现在更常见的问题是等着数据送过来。
“数据是新时代的石油,但更重要的是下半句。”李蓁表示,“石油需要经过冶炼才能成为燃料与化工原料,数据也需要在顺畅的链路中流转、处理,才能真正转化为生产力。当算力不再是绝对瓶颈,数据流动的效率就成了新的短板。”
分层逻辑在AI时代失效
企业级AI Agent场景对性能和数据安全提出极高要求,需防止AI幻觉导致的数据误删,确保集群安全可控运行 。传统基于不同软硬件搭建的碎片化基础设施存在搭建运维复杂、可靠性低、安全性不足及整体拥有成本(TCO)增加等问题 。
在AI爆发之前,分层存储是行业延续了几十年的主流方案:根据数据访问频率,将热数据存放在高性能存储介质,冷数据沉降到低成本层级,以此平衡性能与成本。但这套运行了数十年的逻辑,在AI时代正在失效。
分层架构的核心痛点,在于数据跨层搬运的隐形损耗。AI数据生命周期里,同一份数据时而需要高性能读写,时而需要低成本大容量存储,在传统分层架构中,数据需要在不同层级间反复迁移。
“搬运的过程就会产生巨大开销,GPU长时间处于等待状态,设备持续上电却没有产出,这些成本最终都会由用户买单。”李蓁坦言,多套系统、多类介质对应不同分层,也让架构设计、软件开发与日常运维的复杂度指数级上升。
针对这一痛点,芯展速与VAST Data面向云端AI存储提出了“架构之上无分层”的解决方案:上层构建统一的数据平台,让应用只看到一套系统、一份数据,无需感知底层介质差异。底层则通过不同介质的精准分工,分别承担性能、容量、持久化等不同角色。
李蓁认为,AI存储演进的一个重要方向,就是走向无分层的统一数据平台,而不是多个割裂的层级。
需要指出的是,在全新的方案逻辑下,单凭一家很难去做到通路的打通,而是需要做系统的软件厂商与做硬件的存储厂商深度协同,并非“各做各的”。底层介质需承担更清晰的角色分工,包括高性能、容量经济性、低延时高耐久及全局持久化 。
在李蓁看来,无分层架构的体验上限,由上层架构设计与底层硬件能力共同决定,VAST Data定义了无分层的统一架构,提出了对底层介质的差异化需求。“架构之上无分层”定义的是系统架构,芯展速解决的是介质层怎么支撑它。
据介绍,围绕写入缓冲、容量经济与关键负载性能三个角色,芯展速以SCM、QLC、TLC产品组合分别承接。其中,SCM承担低延迟、高耐久的写入缓冲与全局状态持久化,QLC主打海量数据的容量经济性,TLC保障高并发关键负载的性能弹性。
存储不再是算力的附属品
让存储参与计算,以存力强化算力。AI产业正在回归数据的本质,存储不再是算力的附属品,而是释放算力潜能、实现算力平权的核心底座。不过,当算力狂奔的脚步放缓,随着AI走进更多行业,数据这一层的变革才刚刚来到深水区。
李蓁表示,未来三到五年,最大的变化将是数据存储的下沉与分化。各行各业的用户都会产生定制化的模型与数据,大量个人数据、业务数据需要在本地存储与处理,以存强算、存算协同的边缘与端侧场景,会成为新的增长主线。
但机遇背后,挑战同样清晰。首先是技术迭代的压力,AI数据的增长速度远超行业预期,对存储的性能、容量、耐久度要求还在持续提升,无分层架构的优化没有终点,还有很长的路要走。
另一个则是行业周期的波动,任何新技术都不会保持直线增长,行业必然存在有周期性的起伏。
如何在行业热潮中积极投入抢占技术制高点,同时避免盲目的技术堆砌,在周期波动中保持稳健节奏,是芯展速需要长期面对的命题。(本文首发于钛媒体APP,文 | 志读科技,作者 | 杜志强,编辑 | 杨林)
更多精彩内容,关注钛媒体微信号(ID:taimeiti),或者下载钛媒体App

 读报 ›

